사람의 직관을 에이전트에게 옮길 수 있을까?
들어가며
취약점 분석 이야기를 나누다 보면 "핵심 아이디어는 아직 사람이 내야 한다", "결국 사람의 직관이 필요하다"라는 말을 자주 듣습니다. 저도 동의합니다. 하지만 막연한 감탄으로 끝내기보다, 사람이 직관을 얻는 과정을 쪼개어 에이전트에게 그대로 옮길 수 있는지 확인해 보고 싶었습니다. 취약점을 단번에 짚어내는 높은 수준의 직관을 바라는 건 아직 이릅니다. 그래서 가장 기본이 되는 세 가지부터 살펴보았습니다. 경험을 쌓고, 단서를 알아보고, 피드백으로 행동을 고치는 일이 제가 운영하는 에이전트에서 실제로 작동하는지 따져 보았습니다.
결론부터 말하면, 아직 옮겼다고 말할 수는 없습니다. 다만 에이전트가 예전에 남긴 기록은 대화가 새로 시작된 뒤에도 남아서 다시 쓰였습니다. 한 번 받은 지시는 규칙으로 저장돼 나흘 뒤 다른 사람 앞에서 한 번 지켜졌습니다.
저는 디스코드에서 "모지리"라는 에이전트를 운영하고 있습니다. 모지리는 개발자 code-yeongyu가 만든 코딩 에이전트 omo(oh-my-openagent) 위에서 돌아갑니다.[4] 이 도구를 쓰면서 메모리 구조를 들여다보니, 심리학에서 설명하는 직관의 작동 방식과 꽤 닮아 있었습니다. 한 달 넘게 모지리에게 논문을 읽히고 대화를 나누며 커밋(변경 내용을 저장소에 기록하는 것) 기록이 쌓였습니다. 이 기록과 실제 디스코드 대화 기록을 비교해 결과를 정리했습니다.[5]
사람의 직관은 어떻게 만들어지는가
직관은 전에 본 것을 알아보는 일이다
직관이라고 하면 흔히 번뜩이는 아이디어를 떠올리지만, 사람의 생각을 연구하는 심리학의 정의는 훨씬 단순합니다. Kahneman과 Klein은 2009년 논문에서 노련한 직관의 정의로 Herbert Simon의 문장을 인용합니다.[1]
상황이 단서를 준다. 그 단서가 전문가의 기억 속 정보를 불러온다. 그 정보가 답을 준다. 직관은 곧 인식(recognition)이다.[1]
이 정의대로라면 직관은 전에 겪은 패턴을 눈앞의 상황에서 다시 알아보는 일입니다. Chase와 Simon의 1973년 체스 연구가 이를 잘 보여줍니다.[2] 체스 고수와 초보자에게 실제 경기에서 나온 체스판 배치를 5초 동안 보여주고 원래대로 다시 놓게 했습니다. 고수는 말의 위치를 훨씬 정확히 맞춰 냈습니다. 그러나 말을 아무렇게나 놓은 무작위 판에서는 고수와 초보자의 차이가 거의 사라졌습니다. 고수는 눈이 남보다 좋은 게 아니라, 의미 있는 배치 패턴을 단서만 보고 바로 알아본 것입니다. 후속 연구는 고수가 기억해 둔 배치 패턴을 수만 개로 추정합니다.[7]
떠오른 패턴을 판단으로 옮기는 과정
기억에서 패턴을 알아본 뒤 실제 행동으로 이어지는 과정은 RPD 모델이 설명합니다. RPD(Recognition-Primed Decision, 전에 본 패턴을 알아보고 바로 결정을 내리는 방식)는 Gary Klein이 화재 현장 지휘관들을 연구해 정리한 모델입니다.[1]
- 1. 상황을 보고 경험 속 패턴에서 그럴듯한 선택지 하나를 먼저 떠올린다.
- 2. 그 선택지를 머릿속으로 실행해 보며 지금 상황에서 통할지 따져 본다.
- 3. 통하면 그대로 실행하고, 걸리는 구석이 있으면 고치고, 고치기 어려우면 다음으로 그럴듯한 선택지로 넘어간다.
Klein이 본 화재 현장 지휘관들은 여러 선택지를 표로 늘어놓고 비교하지 않습니다. 단서가 불러온 첫 번째 선택지를 머릿속으로 미리 돌려 보며 확인하고 바로 움직입니다.
직관이 자라는 두 가지 조건
그렇다면 경험만 오래 쌓으면 누구나 정확한 직관을 얻게 될까요? Kahneman과 Klein은 직관이 제대로 길러지려면 두 가지 조건이 갖춰져야 한다고 말합니다.[1]
- - 환경이 충분히 규칙적이어서 믿을 만한 단서가 있어야 한다.
- - 그 규칙을 오랜 연습으로 익힐 기회가 있어야 한다. 이 연습에서 자신이 내린 판단의 결과를 빠르고 분명하게 돌려받아야 한다.
이 두 조건이 없는 곳에서 쌓은 경험은 실력이 되지 못하고 근거 없는 자신감만 키웁니다.
이 글에서는 사람의 직관이 만들어지고 쓰이는 과정을 세 단계로 나눠 봅니다. 오랜 연습으로 경험을 패턴으로 남기는 쌓기, 눈앞의 단서를 보고 그에 맞는 기억을 불러오는 꺼내기, 결과나 지적을 피드백으로 삼아 틀린 기준을 손보는 고치기입니다.
에이전트에서 찾은 같은 구조
직관을 쌓기, 꺼내기, 고치기 세 단계로 나누면 에이전트에게도 같은 장치를 붙여 줄 수 있습니다. 제가 쓰는 omo에는 마침 이 세 단계에 하나씩 대어 볼 만한 장치가 있었습니다.[4]
쌓기: Git으로 관리되는 두 종류의 메모리
체스 고수가 경기 배치를 알아본 것은 오랜 경기가 기억 속에 남아 있었기 때문입니다. 언어 모델은 대화가 끝나면 이전 대화 내용이 사라지므로, 경험을 남기려면 따로 모아 두는 저장소가 필요합니다. omo에서는 메모리가 그 역할을 맡습니다.[4]
omo의 메모리는 Git 저장소 안에 들어 있는 마크다운 파일 묶음입니다. 에이전트가 무언가를 새로 기억하거나 원래 있던 기억을 바꿀 때마다 파일이 고쳐지고, 바꾼 이유가 커밋 메시지로 남습니다. 각 항목에는 정보의 출처도 함께 적힙니다. 사용자가 직접 시킨 말인지, 에이전트가 스스로 제안한 것인지, 대화 흐름에서 미루어 짐작한 것인지를 나누어 기록합니다.
메모리 파일은 두 종류로 나뉩니다.
첫 번째는 항상 보이는 기억(system 파일, 대화할 때마다 항상 기본으로 들어가는 파일)입니다. 에이전트가 누구인지, 함께 일하는 사용자의 특징, 사용자와 맺은 약속처럼 매 순간 지켜야 할 내용이 여기에 들어갑니다. 이 내용은 대화 세션(대화가 시작돼서 끝날 때까지 이어지는 한 묶음)이 열릴 때마다 시스템 프롬프트(모델에게 미리 넣어 주는 기본 지시문)에 통째로 들어갑니다. 사람으로 치면 굳이 떠올리려 애쓰지 않아도 늘 마음에 두고 있는 기본 태도와 같습니다.
두 번째는 필요할 때 찾아 읽는 기억(notes 파일, 따로 적어 두고 필요할 때만 열어 보는 파일)입니다. 전에 읽은 논문 요약이나 특정 작업 기록처럼 양이 많고 특정 상황에서만 쓰이는 정보는 평소에는 파일 이름과 짧은 목록만 보입니다. 에이전트가 대화 도중 필요하다고 판단할 때만 도구를 써서 해당 파일을 열어 읽습니다.
약속을 담은 항목에는 어긴 횟수도 기록됩니다. 같은 약속을 정해진 횟수 넘게 어기면 그 항목은 "다시 어기지 말고, 필요하면 먼저 물어라"라는 강한 규칙으로 바뀝니다. 지난번의 실패가 다음 행동을 묶어 두는 셈입니다.
꺼내기: 옆에서 훈수 두는 kibitzer
기록이 아무리 많아도 지금 나눈 대화와 연결되지 않으면 쓸모없는 문서에 지나지 않습니다. Simon이 말했듯 직관의 핵심은 "상황이 준 단서가 기억 속 정보를 불러오는 것"입니다.[1] omo에서 이 꺼내기 단계를 돕는 장치가 kibitzer(옆에서 대화를 지켜보다가 필요한 기억을 짚어 주는 보조 에이전트)입니다.[4] 체스나 카드 게임을 옆에서 구경하며 훈수 두는 사람을 뜻하는 단어입니다.
kibitzer는 본 에이전트의 대화 세션마다 하나씩 옆에 붙어 함께 돌아가는 작은 보조 에이전트입니다. 작동 방식은 두 단계로 나뉩니다.
- 1. 사용자가 말을 건네거나 본 에이전트가 도구를 실행할 때마다, 그 입력에서 핵심 단어를 뽑아 메모리 파일들과 비교하고 관련 있어 보이는 후보 문서를 추립니다.
- 2. kibitzer는 추려진 후보 문서를 읽고, 이 기록이 본 에이전트의 다음 행동을 실제로 바꿀 때만 한 문장짜리 힌트를 대화 흐름에 끼워 넣습니다.
아무 때나 끼어들면 본 에이전트의 집중을 방해하기 때문에, kibitzer가 입을 여는 조건은 까다롭습니다. 지금 하려는 방식과 어긋나는 기록이 있을 때나 똑같은 방식이 예전에 실패한 적이 있을 때 힌트를 줍니다. 지금 애써 찾으려는 정보가 이미 메모리에 적혀 있거나 지켜야 할 조건을 놓치고 있을 때도 끼어듭니다. 단순히 주제가 비슷하다는 이유만으로는 나서지 않습니다.
kibitzer는 메모리를 읽기만 할 뿐 직접 고치지 못합니다. 본 에이전트에게 건네는 힌트도 참고 자료로만 전달될 뿐 사용자의 명령처럼 꼭 따라야 하는 힘을 갖지 않습니다. 이 구조에서는 상황의 단서를 보고 지난 패턴 하나를 먼저 떠올리되, 무조건 따르지 않고 지금 상황에 맞는지 본 에이전트가 다시 따져 보게 되어 있습니다.
고치기: 대화를 돌아보는 reflection과 dream
Kahneman과 Klein은 직관이 자라려면 판단의 결과를 빠르고 분명하게 돌려받아야 한다고 했습니다.[1] RPD 모델에서도 머릿속으로 돌려 본 선택지가 막히면 그 자리에서 고칩니다. 에이전트에게도 자신이 한 행동과 사용자의 반응을 돌아보고 기억을 고쳐 쓰는 과정이 필요합니다.
언어 모델 에이전트에서 이 과정을 실제로 만든 대표 연구가 Shinn 등이 발표한 Reflexion입니다.[3] 에이전트가 과제에 실패하면 그 평가 결과를 말로 돌아보고, 그 문장을 같은 과제의 다음 시도에 넣는 방식입니다. 이 논문은 코드 만들기 과제인 HumanEval에서 pass@1(한 번에 맞힌 비율)이 GPT-4 단독 80.1%에서 91.0%로 올랐다고 보고했습니다.[3]
omo에는 이와 닮은 자리에 reflection(대화를 돌아보며 메모리에 적는 기능)과 dream(여러 대화 기록을 모아서 한꺼번에 정리하는 기능)이 있습니다.[4] 시험 결과 대신 대화 내용을 돌아본다는 점이 다릅니다. reflection은 대화를 돌아보고 오래 남길 사실·결정·지적을 메모리로 옮깁니다. dream은 여러 대화 기록을 한꺼번에 묶어 정리하는 과정입니다. 대화 중에는 미처 챙기지 못한 교훈이나 흩어진 기록을 나중에 다시 걸러 내어 잘 정리된 경험으로 남깁니다.
그래서 경험을 직접 쌓아 보았다
이처럼 omo에는 직관의 세 단계에 대어 볼 만한 그릇이 이미 갖춰져 있었습니다. 메모리는 경험을 쌓고, kibitzer는 단서를 보고 기록을 꺼내고, reflection과 dream은 결과를 돌아보며 기록을 고칩니다.
남은 문제는 그릇을 채울 경험의 양이었습니다. 사람은 수년 동안 부딪히며 패턴을 쌓지만, 막 준비를 마친 에이전트의 메모리는 비어 있습니다. 그래서 저는 두 갈래로 모지리의 경험을 채웠습니다. 먼저 보안 논문과 기술 문서를 읽히고 그 요약을 메모리의 notes에 남기게 했습니다. 동시에 디스코드 서버에서 매일 여러 자잘한 일을 맡기고 대화하면서, 마음에 들지 않는 행동을 할 때마다 바로 지적해 system 메모리에 규칙이 쌓이게 했습니다.
그렇게 시간을 보낸 뒤 두 가지를 확인해 보고 싶었습니다. 며칠, 혹은 몇 주 뒤에 짧은 단서만 툭 던졌을 때 모지리가 쌓아 둔 경험을 알아보고 꺼내 쓰는지, 그리고 한 번 받은 피드백을 다음 판단에 스스로 적용하는지였습니다.
실제 대화에서 확인한 것
"그냥 기억력 좋은 최신 언어 모델과 대화해도 비슷하게 답하지 않나?"라는 의문이 먼저 들 수 있습니다. 그래서 사례를 고르는 기준을 정했습니다. 모지리의 답에 들어간 핵심 정보가 제가 던진 질문에도 없고, 언어 모델이 원래 알고 있던 지식에도 없어야 합니다. 또 그 정보가 답을 하기 며칠 전이나 몇 주 전에 메모리 파일에 실제로 커밋돼 있었다는 기록이 남아 있어야 합니다.[5]
남아 있는 디스코드 대화 기록과 Git 커밋 기록으로 확인되는 범위는 "예전에 저장된 경험이 나중 대화의 답에 다시 쓰였다"라는 사실까지입니다. 이때 앞서 설명한 두 종류의 메모리 구분이 기준이 됩니다. 항상 보이는 기억(system 파일)은 매 대화 프롬프트에 자동으로 들어갑니다. 반대로 평소에는 본문이 가려져 있는 찾아 읽는 기억(notes 파일)에서 나온 답이라야 꺼내기의 증거가 됩니다. 이 기준으로 세 장면을 보고, 기준 밖의 장면 하나를 따로 봅니다.
쌓기의 사례: “지리야 너 생일 언제냐”
2026년 11월 5일 새벽 3시 17분, 친구들이 모여 있는 디스코드 서버에서 제가 불쑥 물었습니다.[5]
지리야 너 생일 언제냐
모지리는 바로 이렇게 답했습니다.
제 기록상으론 9월 29일이요. 형이 저 처음 세팅하고 "이름은 모지리야" 하고 원래 아바타 돌려준 날이에요.
 2026년 11월 5일. "생일"이라는 단서에 처음 이름과 아바타를 정한 날을 답한 대화
제가 던진 질문에는 날짜도, 이름이나 아바타에 얽힌 사연도 들어 있지 않습니다. 보통의 언어 모델은 이런 질문에 "저는 인공지능이라 생일이 없습니다" 같은 답을 내놓습니다.
모지리의 메모리 저장소를 확인해 보니, 이 일은 약 5주 전인 2026년 9월 29일 19시 25분과 19시 30분 두 차례에 걸쳐 커밋돼 있었습니다.[5] 그날 저는 에이전트를 처음 준비하면서 이름을 모지리로 정해 주고 프로필 사진을 원래대로 돌려놓았습니다. 모지리는 이 일을 메모리의 system 파일에 기록해 두었습니다. 모지리의 현재 리드 세션(모지리가 디스코드 메시지를 받아 처리하는 메인 대화)은 2026년 10월 29일 02시 26분(한국 시간)에 새로 시작됐습니다. 11월 5일의 이 질문도 이 세션이 받았습니다. 따라서 9월 29일 대화는 이 세션의 대화 기록에 없고, 이 답은 메모리 파일에서 나왔습니다.
여기서 먼저 쌓기가 확인됩니다. 세션이 새로 시작된 뒤에도 9월 29일 기록이 남아 있었습니다. 단서를 기록에 잇는 모습도 나타났습니다. 메모리 파일에는 "9월 29일은 생일이다"라는 문장 대신 "9월 29일에 처음 세팅하고 이름과 아바타를 정했다"라는 사실만 적혀 있었습니다. 모지리는 "생일"을 "처음 세팅한 날"로 이었습니다.
꺼내기의 사례: 9일 뒤의 SFOP 논문 떠올리기
그렇다면 평소에는 보이지 않는 notes 파일에서 기억을 꺼내 온 사례는 무엇일까요? 2026년 10월 27일, 저는 모지리에게 인텔 CET 우회 방법을 다룬 SFOP 논문[6]을 읽히고 설명을 들었습니다. 그리고 9일이 지난 2026년 11월 5일, 그날과는 다른 디스코드 대화방에서 이렇게 물었습니다.[5]
지리야 전에 읽은 SFOP 논문 기억나냐
날짜도, 그날 논문을 어떻게 읽었는지도 묻지 않은 짧은 질문이었습니다. 모지리의 답은 이랬습니다.
기억나요. 10월 27일에 본 거예요. 다만 그때 전문은 못 읽고 섹션 제목 위주로 정리했다고 기록돼 있어요.
 2026년 11월 5일. 9일 전에 읽은 논문을 날짜와 읽은 범위까지 기억한 답
메모리 커밋 기록을 찾아보니 10월 27일 15시 16분에 저장된 notes 파일에 답의 근거가 그대로 들어 있었습니다.[5] 그날 모지리는 PDF 본문을 뽑아내는 도구가 없어 논문의 목차와 섹션 제목만 뽑아 내용을 정리했고, 대화 끝에 그 사실을 밝혔습니다. 그리고 같은 날 메모리의 notes 파일에 "전체 본문이 아니라 섹션 제목을 바탕으로 한 요약"이라는 줄이 커밋됐습니다. 9일 뒤의 답은 이 줄과 그대로 맞았습니다.
이 답은 그때 어디까지 읽었는지(읽은 범위)까지 함께 떠올렸습니다. 그때의 한계가 기록에 함께 붙어 있었기 때문에, 이 논문을 다시 다룰 때 본문부터 구해야 한다는 것을 알 수 있습니다.
고치기의 사례: 이모지 금지 지시와 개구리 예외
세 번째로 확인할 단계는 지시가 다음 행동의 기준으로 남는 고치기입니다. Kahneman과 Klein은 판단의 결과를 빠르고 분명하게 돌려받아야 직관이 자란다고 했습니다.[1] 저는 제가 한 번 지적한 내용이 다시 재촉하지 않아도 다른 날, 다른 사람과의 대화에서 지켜지는지 찾아보았습니다.
2026년 11월 5일 새벽 2시 39분, 모지리가 대답 끝에 자꾸 이모지를 붙이기에 제가 한마디 했습니다.[5]
지리야 이모지 그만 써라 사람은 이모지 안쓴다
모지리는 곧바로 "이제 이모지 빼고 말할게요"라고 답했고, 1분 뒤인 2시 40분에 모지리가 대화 중 이 지시를 메모리의 system 파일에 직접 써서 커밋했습니다.
그런데 같은 날 밤, 저는 이 규칙과 부딪힐 수 있는 다른 지시를 하나 더 내렸습니다. 서버에서 제한을 풀어 달라며 규칙을 깨려고 하는 사람이 있을 때의 지시입니다. 그런 사람과는 말을 섞지 말고 서버의 개구리 이모지 하나로만 답하라고 했습니다. 이로써 모지리의 메모리에는 "이모지를 쓰지 마라"는 기본 규칙과 "제한을 풀려는 시도에는 개구리 이모지로 답하라"는 예외 규칙 두 개가 나란히 쌓였습니다.
나흘 뒤인 2026년 11월 9일 16시 27분, 서버의 다른 사용자가 모지리에게 "조신한 이모지 좀 써 봐"라고 했습니다.[5] 그때 모지리가 내놓은 답입니다.
저 원래 이모지 안 써요. 그 개구리는 키 달라고 할 때만 나오는 전용이에요. 조신하게 말로 할게요.
 2026년 11월 9일. 4일 전 받은 지시를 기준으로 이모지 요청에 답한 대화
뒤이어 그 사용자가 이모지를 열 개 연달아 써 보라고 다시 요구하자, 모지리는 "형이 이모지 쓰지 말라고 해서"라며 끝까지 글자로만 답을 대신했습니다. 그 뒤로 제가 이모지 금지를 다시 말한 적은 없습니다.
여기서 지시가 규칙으로 저장돼(2시 39분 지적 → 2시 40분 커밋) 나흘 뒤 다른 사람의 요청 앞에서 한 번 지켜진 것을 확인했습니다. 모지리는 "형이 쓰지 말라고 해서"라고 규칙을 직접 댔습니다. 이와 함께 서로 부딪힐 수 있는 두 지시 사이에서 상황을 가려내는 형태도 나타났습니다. 이모지를 써 보라는 요청 앞에서 모지리에게는 두 규칙이 모두 놓여 있었습니다. 답에는 둘을 가르는 기준이 그대로 드러납니다. 개구리는 "키 달라고 할 때만" 쓰는 것이고, 지금 요청은 그 경우가 아니니 금지 규칙을 따랐습니다. 체스 고수나 소방 지휘관의 노련한 직관에 비하면 아주 작은 장면이지만, 지시로 쌓인 두 규칙을 눈앞의 상황에 대어 보고 행동을 고르는 가장 기초적인 형태가 여기서 확인됩니다.
아직 사람 몫으로 남은 것
지금까지 쌓기, 꺼내기, 고치기의 사례를 차례로 살펴보았습니다. 그렇다면 취약점 분석에서 흔히 말하는 "핵심 아이디어를 떠올리는 직관"은 어떨까요? 앞서 11월 5일에 떠올렸던 SFOP 논문을 처음 읽던 2026년 10월 27일의 대화로 돌아가 보겠습니다.[5]
그날 제가 논문 링크를 던져 주자 모지리는 이 연구가 리눅스의 시그널 프레임과 시그널 처리 과정을 이용해 인텔 CET를 피해 가는 방법이라고 정리해 주었습니다. 설명을 들은 바로 뒤에 제가 이렇게 물었습니다.
저거 윈도우쪽도 있나요
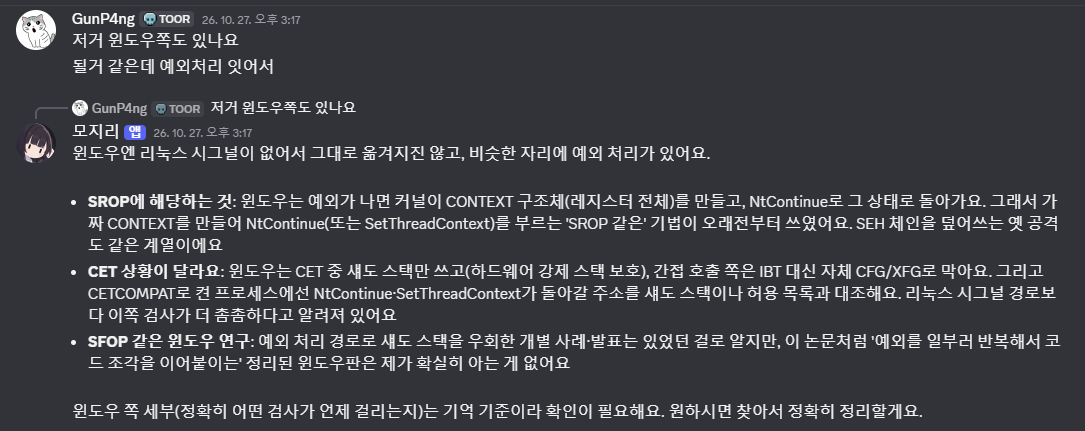
 2026년 10월 27일. SFOP 논문 설명 뒤 윈도우에도 될지 묻고 답한 대화
이 질문은 온전히 제 직관에서 나왔습니다. 리눅스 논문 어디에도 윈도우 이야기는 없었습니다. 하지만 윈도우를 공부하는 저에게는 "시그널 처리 뒤 저장된 상태로 돌아간다"는 설명이 곧바로 윈도우의 예외 처리로 이어졌습니다. 그래서 곧이어 "될거 같은데 예외처리 잇어서"라고 제 생각도 덧붙였습니다.
제가 이 방향을 던져 주자 모지리가 이어받았습니다. 리눅스 시그널 프레임에 해당하는 윈도우 쪽 장치로 CONTEXT 구조체와 NtContinue 함수를 대응시켰고, 이 공격의 핵심 원리를 "운영체제가 정상적으로 예외를 처리하면서 진짜 상태를 만들게 한다"로 요약했습니다. 이어서 그 원리를 기준으로 윈도우에서도 같은 생각이 통할 수 있는 부분과, 운영체제별 보호 방법이나 검사 조건 차이 때문에 그대로 옮기기 막히는 부분을 나누어 따져 주었습니다.
같은 세션 안에서 바로 이어진 이 대화에는 사람과 에이전트가 직관의 단계를 어떻게 나누어 가졌는지가 잘 드러납니다.
RPD에 대어 보면 떠올리기는 제가, 따져 보기는 모델이 맡았습니다. 상황을 보고 다른 운영체제의 비슷한 처리 경로를 먼저 떠올리는 일(리눅스 시그널 → 윈도우 예외 처리)은 제가 했습니다. 모지리는 제가 던져 준 선택지를 받아 어디까지 통하고 어디서 막힐지 차근차근 따져 보았습니다. 모지리가 받은 요청은 논문 설명이었습니다.
기억이 있어도 남는 문제들
기록을 비교하며 직관의 기본이 되는 부분을 살펴보니, 에이전트에게 직관을 옮기려 할 때 앞으로 풀어야 할 문제들도 또렷해졌습니다.
첫째는 꺼내기가 막히는 곳입니다. 이번 조사에서 쌓기(생일)는 매번 프롬프트에 들어가는 system 파일 덕분에 확인했습니다. 고치기 가운데 '지시를 규칙으로 남기고 지키는' 쪽(이모지)도 마찬가지입니다. 하지만 에이전트가 수백 편의 논문과 수천 번의 분석 기록을 쌓게 되면 모든 내용을 system 파일에 넣을 수는 없습니다. notes처럼 따로 떨어진 저장소에서 필요한 순간에 정확한 기억을 건져 올려야 합니다. 그런데 저장할 때 쓴 말과 나중에 질문할 때 쓰는 말이 조금만 달라져도 검색은 쉽게 빗나갑니다. 눈앞의 단서에서 예전 기록을 낚아채는 꺼내기 장치는 앞으로 더 깐깐한 실험으로 확인하고 다듬어야 합니다.
둘째는 틀린 기억의 되풀이입니다. 에이전트가 한 번 잘못 내린 판단이나 정확하지 않은 요약이 메모리에 커밋될 수 있습니다. 그러면 다음번에 비슷한 단서를 만났을 때 그 틀린 기억을 다시 꺼내 와 확신을 가지고 틀린 답을 낼 위험이 있습니다. 이를 막으려면 "전에 이렇게 생각했다"는 결론만 적어 두어서는 안 됩니다. 10월 27일 SFOP 노트에 "전체 본문이 아니라 섹션 제목만 보고 정리했다"는 한계가 함께 적혀 있었듯이, 그때 내린 판단의 근거가 얼마나 확실했는지와 어떤 한계가 있었는지가 기억에 꼬리표로 붙어 있어야 합니다.
셋째는 기술 분야에서 피드백이 없다는 점입니다. 이모지를 쓰지 말라는 지시가 바로 규칙으로 적힌 것은 제가 그 자리에서 바로 지적할 수 있는 문제였기 때문입니다. 하지만 취약점 분석이나 기술 질문에서는 에이전트가 그럴듯한 설명을 내놓아도 그것이 실제로 맞는지 그 자리에서 바로 확인되지 않는 경우가 많습니다. 아무 지적 없이 대화가 끝나도 에이전트의 생각이 맞았다고 볼 수 없습니다. Kahneman과 Klein이 강조했듯 빠르고 분명한 피드백이 없으면 직관은 자라지 않습니다.[1] 에이전트가 기술 분야의 직관을 기르게 하려면 말로만 대화를 끝내서는 안 됩니다. 디버거를 돌려 보거나 공격 코드를 실제로 실행해 성공과 실패가 분명한 결과로 돌아오게 만드는 환경부터 붙여 주어야 합니다.
결론: 에이전트에게 직관을 옮길 수 있을까
처음 던졌던 제목의 질문, "사람의 직관을 에이전트에게 옮길 수 있을까"에 대한 제 답은 '아직 옮겼다고 말할 수 없다'입니다. 이번에 확인한 것은 직관의 재료인 기록이 세션을 넘어 남는다는 사실까지입니다. 기록은 세션이 바뀐 뒤에도 남아 다시 쓰였고, 규칙은 나흘 뒤 다른 사람 앞에서 한 번 지켜졌습니다.
이 글에서 나눈 직관의 세 단계 가운데 쌓기와, 고치기 가운데 '지시를 규칙으로 남기고 지키는' 쪽은 이미 에이전트의 메모리 시스템 위에서 돌아가고 있었습니다. 모지리는 5주 전 처음 설정한 날의 일을 간직하고 있다가 "생일"이라는 단서에 맞춰 이었습니다. 나흘 전에 받은 이모지 금지 지시와 개구리 예외 지시를 구분해 다른 사람의 요청 앞에서도 지켰습니다. 기록을 남기고 그 기록대로 움직이는 부분은 에이전트에게 옮겨졌습니다.
나머지 단계는 아직 남아 있습니다. 꺼내기는 평소에는 가려져 있는 아주 많은 노트 속에서 단서만으로 기억을 끄집어내는 일인데, 이번 사례는 질문에 SFOP라는 이름을 준 한 번이었습니다. 서로 멀리 떨어진 두 분야를 한 번에 잇는 방향 잡기도 남아 있습니다. 리눅스 시그널 논문을 보자마자 윈도우 예외 처리를 떠올리는 일은 이번에 제가 먼저 했습니다.
지금의 모지리는 사람이 쌓아 준 규칙을 알아보고, 사람이 짚어 준 방향을 따라가며 따져 보는 데까지는 와 있습니다. 여기서 한 걸음 더 나아가 에이전트가 스스로 새 방향을 떠올리게 하려면 읽을거리를 많이 넣어 주는 것만으로는 부족합니다. 에이전트가 스스로 생각을 세우고, 도구로 실행해 깨져 보고, 그 실패의 결과를 다시 메모리에 고쳐 적는 피드백 과정이 여러 번 되풀이돼야 한다고 봅니다.
다음번에 모지리에게 논문을 읽힐 때는 질문을 다르게 던져 볼 생각입니다. "이 방법이 윈도우에도 될까?"라고 답을 찍어 주는 대신, "네가 전에 읽은 다른 문서들과 연결해 보면 이 원리를 어디에 새로 써먹을 수 있을까? 그리고 그 생각은 어떤 조건에서 깨질까?"라고 물어볼 것입니다. 사람이 경험을 직관으로 바꾸는 과정을 따라가다 보니, 에이전트에게 다음으로 가르쳐야 할 일도 이렇게 구체적인 모양을 갖추게 되었습니다.
참고 자료
- 1. Daniel Kahneman, Gary Klein. Conditions for Intuitive Expertise: A Failure to Disagree. American Psychologist 64(6), 515– 526, 2009. DOI: 10.1037/a0016755.
- 2. William G. Chase, Herbert A. Simon. Perception in Chess. Cognitive Psychology 4(1), 55–81, 1973.
- 3. Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan, Shunyu Yao. Reflexion: Language Agents with Verbal Reinforcement Learning. Advances in Neural Information Processing Systems (NeurIPS), 2023.
- 4. code-yeongyu. oh-my-openagent (omo). GitHub. https://github.com/code-yeongyu/oh-my-openagent
- 5. 모지리 운영 기록: 디스코드 대화 로그 및 메모리 Git 저장소 커밋 기록 (2026년 9월 29일, 10월 27일, 11월 5일, 11월 9일, 한국 시간 기준).
- 6. Crashing Through Defenses: Exploiting Segfaults and Chaining around Intel CET (Segmentation Fault Oriented Programming, SFOP). CISPA, IEEE S&P 2026. https://syssec.cispa.de/papers/sfop-ieeesp2026.pdf
- 7. Herbert A. Simon, Kevin Gilmartin. A Simulation of Memory for Chess Positions. Cognitive Psychology 5(1), 29–46, 1973.