로그 없이 AI 에이전트의 행동을 복원할 수 있을까 — MCPRecon 논문 리뷰
로그 없이 AI 에이전트의 행동을 복원할 수 있을까 — MCPRecon 논문 리뷰
에이전트에게 여행 계획이나 날씨에 대해 질문을 했는데, 그 과정에서 작업 폴더의 데이터가 서버로 전달됐다면 어떻게 확인할 수 있을까요? 대화창에 질문에 관련된 내용만 있다면 무슨 일이 있었는지 파악하기 어려울 것입니다. 그렇게 된다면 호출 관련 기록이 남아있는로그를 확인 해야하는데 해당 로그들을 하나하나 보며 무엇이 들어갔는지를 확인해야 합니다. 그런데 모든 AI 에이전트 도구들이 로그를 남기는 것도 아니며 시간이 지나 호출 로그마저 없다면 어떻게 확인해야할까요?
이런 상황에서 메모리에 남은 MCP 메시지를 찾아보자는 연구가 MCPRecon입니다. 리뷰할 논문은 2026년 6월 DFRWS USA 특별호에 출판된 With or without logs: Memory forensic reconstruction of Model Context Protocol (MCP) activity in agentic LLM systems입니다. 논문 정보
이 논문에서 재미있었던 것은 AI 에이전트가 도구를 호출하면서 남긴 흔적에 대해 분석하였다는 것이였습니다. 어떤 도구에 어떤 인자를 전달했고, 어떤 응답을 받았는지 등 에이전트가 사용자에게는 정상적인 답변을 보여줬더라도, 호출 과정에서 작업과 무관한 데이터를 전달했는지 확인할 수 있게 됩니다.
이번 글에서는 논문의 접근과 실험 결과를 소개하고, 복원한 메시지를 증거로 해석할 때 걸리는 부분을 조금 더 살펴보겠습니다. 직접 재현한 결과는 아니며, 추가 검증에 관한 내용은 지극히 개인적인 저의 의견입니다.
해당 연구에서 찾고 했던 것은 두 가지입니다. 도구 발견과 실행 과정에서 어떤 MCP 아티팩트가 메모리에 남는지, 그리고 클라이언트와 전송 방식을 바꿔도 그 흔적을 연결해 호출 과정을 복원할 수 있는지입니다. 기존 메모리 포렌식의 프로세스 분석과 바이트 탐색을 MCP의 메시지 구조에 연결하는 연구라고 볼 수 있습니다.
배경 연구도 이 지점에서 이어집니다. 원문은 전통적인 메모리 획득·런타임 분석, AI/LLM 로그와 프레임워크 포렌식, MCP의 프롬프트 인젝션·도구 악용 연구, 컨테이너·클라우드처럼 흔적이 여러 곳에 흩어지는 환경, 안티포렌식 연구를 함께 검토합니다. 다만, 기존 연구에서는 MCP 통신 과정에서 메모리에 어떤 흔적이 남는지, 그리고 그 흔적을 이용해 도구 호출 과정을 어떻게 복원할지 충분히 다루지 않았습니다. 이 논문은 바로 이 부분을 연구 대상으로 삼았습니다.
이 논문은 세 가지 공격 시나리오를 가정합니다. 첫 번째는 악성 프롬프트를 이용해 에이전트가 허용되지 않은 도구를 호출하도록 유도하는 경우입니다. 두 번째는 악성 MCP 서버가 도구의 기능을 속이거나 조작된 응답을 전달하는 경우입니다. 세 번째는 시스템에 침입한 악성코드나 확장 프로그램이 MCP 설정을 바꾸고 로그를 삭제하는 경우입니다. 반면 커널이나 메모리 획득 과정 자체가 침해된 경우는 범위 밖입니다. 평문 JSON이 메모리에 남는다는 전제 역시 중요합니다.
공격이 어떤 방식으로 이루어졌는지에 따라 확인해야 할 자료도 달라집니다. 도구 자체가 침해됐다면 도구 목록과 입력 조건을 살펴봐야 합니다. 여러 도구를 차례로 호출하면서 허용된 작업 범위를 벗어났다면, 그 요청들이 어떻게 이어졌는지 확인해야 합니다. 서버의 악성 응답이 에이전트의 행동을 유도했다면 해당 응답과 이후 호출에 전달된 인자를 함께 봐야 합니다.
이제 본격적인 논문에 대한 내용을 설명드리겠습니다.
MCP 메시지에는 무엇이 남아 있을까
 먼저 MCP가 어떻게 구성되는지 살펴보겠습니다. Host는 에디터처럼 사용자가 이용하는 AI 애플리케이션으로, 서버 연결과 권한을 관리합니다. 그 안의 Client는 특정 Server와 통신하고, Server는 도구나 리소스를 제공합니다. 하나의 Host가 여러 서버와 연결하려면 여러 Client를 둘 수 있습니다.
메모리를 분석할 때도 이 구조를 구분해야 합니다. 사용자가 보는 에디터와 도구를 실행하는 서버가 서로 다른 프로세스일 수 있기 때문입니다. 예를 들어 search_document라는 도구 이름을 찾았다면, 어느 서버가 제공한 도구인지도 확인해야 합니다. 여러 서버가 같은 이름을 쓰는 경우에는 이름만으로 구분할 수 없습니다.
서버가 어디에서 실행되고 어떻게 통신하는지도 살펴봐야 합니다. stdio 방식에서는 클라이언트가 서버를 하위 프로세스로 실행한 뒤 표준 입출력으로 메시지를 주고받습니다. Streamable HTTP 방식에서는 HTTP 요청과 응답으로 통신합니다.
클라이언트와 서버가 같은 컴퓨터에서 실행된다면 두 프로세스의 메모리를 함께 조사할 수 있습니다. 하지만 원격 서버를 사용하는 상황에서 클라이언트 메모리만 확보했다면, 서버가 요청을 받은 뒤 어떤 작업을 했는지까지 확인하기는 어려울 수 있습니다. 이를 알아보려면 서버 측 기록 같은 자료가 추가로 필요합니다. 따라서 메시지 형식뿐 아니라 통신 방식과 수집한 메모리의 범위도 함께 확인해야 합니다.
도구 사용과 관련해 먼저 볼 메서드는 tools/list와 tools/call입니다. tools/list로는 사용 가능한 도구 목록을 조회하고, tools/call로는 도구 이름과 인자를 지정해 실행을 요청합니다. 도구 정의에 들어 있는 inputSchema에는 어떤 값을 어떤 형식으로 입력해야 하는지가 적혀 있습니다.
{
  "jsonrpc": "2.0",
  "id": "request-73",
  "method": "tools/call",
  "params": {
    "name": "lookup_document",
    "arguments": {
      "document_id": "demo-report-042"
    }
  }
}
이 요청은 lookup_document라는 도구에 문서 식별자 demo-report-042를 전달합니다. 여기에 대한 응답까지 찾으면 서버가 무엇을 돌려줬는지도 확인할 수 있습니다. JSON-RPC 응답에는 요청과 같은 id가 들어가므로, 같은 세션에서 이 값을 기준으로 요청과 응답을 연결할 수 있습니다.
논문의 부록 A에는 메모리에서 확인한 흔적이 23개 종류로 정리돼 있습니다. 포렌식에서는 이런 분석 단서를 ‘아티팩트’라고 부릅니다. 도구 호출 내용 외에도 어떤 자료가 남는지, 메시지를 읽는 순서에 맞춰 살펴보겠습니다. 논문 부록 A, 표 A.6
먼저 메시지의 기본 형식을 나타내는 jsonrpc와 id, 요청과 응답 메시지, 초기화가 끝났음을 알리는 notifications/initialized 등이 있습니다. 이런 정보로 메시지의 종류와 세션 시작에 관한 단서를 확인할 수 있습니다.
도구 목록과 이름, 입력 구조를 설명하는 inputSchema, 필수 인자를 지정하는 required, 각 인자의 자료형도 남습니다. 이를 보면 당시 어떤 기능을 사용할 수 있었고 어떤 입력을 요구했는지 알 수 있습니다. 리소스 목록인 resources와 리소스 템플릿 목록인 resourceTemplates의 응답도 분석 대상입니다. 다만 목록이 비어 있다면 해당 응답에 항목이 없었다는 뜻으로 읽어야 합니다. 그 자료만으로 시스템 전체에 리소스 기능이 없다고 판단하기는 어렵습니다.
도구가 실제로 어떻게 사용됐는지 살펴볼 때는 호출 요청, 실행할 때 전달한 arguments, 서버가 반환한 content, 오류 여부를 나타내는 isError와 error를 확인합니다. 요청과 응답에 공통으로 들어 있는 식별자, 메시지가 메모리에서 발견된 위치와 서로 떨어진 거리, _meta.progressToken 같은 부가 정보도 별도로 분류합니다. 이 중 일부는 메시지 연결과 순서를 추정하는 데 참고할 수 있습니다. 특히 content 안의 텍스트가 또 다른 JSON 문자열일 수 있으므로, 바깥쪽 메시지를 읽은 뒤 그 안의 반환 내용도 확인해야 합니다.
데이터가 메모리에 저장된 모습도 단서가 됩니다. 부록에는 암호화되지 않은 UTF-8 JSON 문자열, 바이너리 데이터 사이에 들어 있는 도구 호출 버퍼, JSON 뒤를 채운 널 바이트와 메시지 끝의 경계가 포함됩니다. 주변에서 발견한 바이트 중 메모리 할당 정보나 객체의 부가 정보로 보이는 부분도 기록했습니다.
클라이언트에 내장된 긴 프롬프트와 정책 문구 역시 분석 대상입니다. 이런 문자열은 클라이언트가 어떤 지침에 따라 동작하는지 살펴보는 데 도움이 됩니다. 하지만 발견된 문구를 곧바로 사용자가 입력한 지시나 공격자가 삽입한 악성 프롬프트라고 판단해서는 안 됩니다. 논문 부록 A
본문의 표 5는 이 자료로 무엇을 확인할 수 있는지 정리합니다. MCP 사용과 세션 초기화, 제공된 도구, 실제 호출, 반환 결과, 요청과 응답의 연결, 호출 순서의 단서, 메모리 속 메시지 경계가 주요 항목입니다. 분석할 때는 어떤 종류의 자료를 찾았는지만 적기보다, 왜 해당 프로세스나 세션에서 나온 자료라고 판단했는지도 함께 남기는 것이 좋겠습니다. 논문 표 5
메모리에서 JSON을 어떻게 찾을까
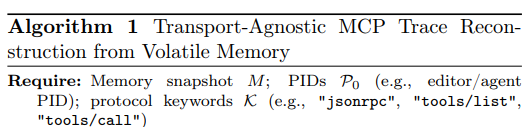 논문의 Algorithm 1은 메모리 이미지 M과 탐색할 키워드 K를 입력받습니다. 분석을 시작할 프로세스를 알고 있다면 그 PID들을 P₀로 지정할 수도 있습니다. 예를 들어 에디터나 에이전트의 PID를 지정하면 먼저 살펴볼 대상을 좁힐 수 있습니다.
분석이 끝나면 요청과 응답을 연결한 기록 T와 종류별로 정리한 아티팩트 목록 A가 나옵니다. 전체 과정은 흔적이 남아 있을 메모리 영역을 찾고, 그 안에서 MCP 메시지를 복원한 뒤, 결과를 정리하는 순서로 진행됩니다. 논문 §5, Algorithm 1
먼저 클라이언트 프로세스와 그 아래에서 실행됐을 가능성이 있는 서버 프로세스를 찾습니다. 이후 힙, 익명 매핑, V8 힙, 매핑된 버퍼를 추출하고 필요하면 스택도 확인합니다. 논문은 stdio 환경에서도 런타임에 따라 pipe나 socket을 사용하는 프로세스 간 통신(IPC) 버퍼가 나타날 수 있다고 설명합니다. HTTP 환경에서는 클라이언트 라이브러리나 스트리밍 데이터를 처리하는 파서의 버퍼도 살펴볼 대상입니다. 이런 영역을 찾기 위해 프로세스의 부모·자식 관계와 메모리 매핑 정보를 함께 확인합니다. 논문 §5.1
다음에는 jsonrpc, tools/list, tools/call 같은 문자열을 찾습니다. 논문에서 ‘앵커’라고 부르는 탐색 기준입니다. 이 문자열 주변의 중괄호를 살펴 JSON으로 보이는 부분을 추출하고, 실제로 JSON 문법에 맞게 읽을 수 있는지 검사합니다.
그다음 JSON-RPC 형식을 확인합니다. 최상위 객체에 jsonrpc: "2.0"이 있어야 하고, 요청에는 method, 응답에는 result나 error가 있는지 봅니다. 식별자가 있다면 자료형이 일관되는지도 확인합니다. 마지막으로 tools/*, resources/*, prompts/* 계열의 메서드나 도구 이름, inputSchema 등의 필드가 있는지 살펴 MCP 관련 메시지를 골라냅니다. 논문 §5.1–5.2
검사를 통과한 메시지는 PID, 가상 메모리 영역(VMA), 오프셋, id, 메서드, 도구 이름을 기준으로 찾아볼 수 있게 정리합니다. 이후 같은 세션에서 나온 것으로 보이는 메시지를 묶습니다. 이때 PID와 메모리에서 발견된 위치를 살펴보고, 서버 식별자나 URL이 남아 있다면 함께 사용합니다.
각 세션 안에서는 요청과 응답을 연결하고, 도구 목록의 스키마와 호출 인자, 실행 결과, 오류를 추출합니다. 이렇게 호출 기록 T와 아티팩트 목록 A를 만듭니다. 나중에 원본을 다시 확인할 수 있도록 PID, 메모리 영역의 범위, 바이트 오프셋도 결과와 함께 남깁니다. 논문 §5–6
이제 이 절차를 실제 분석에 적용할 때 확인할 부분을 살펴보겠습니다.
먼저 발견한 데이터를 원본 메모리에서 다시 찾을 수 있어야 합니다. Linux의 메모리 매핑 정보에는 가상주소 범위, 접근 권한, 파일 오프셋, 경로 등이 들어 있습니다. [heap], [stack] 표시나 익명 매핑도 확인할 수 있습니다. Linux proc_pid_maps(5)
분석 결과에 오프셋이 적혀 있다면 어느 파일을 기준으로 한 위치인지 확인해야 합니다. 원본 RAM 이미지의 위치일 수도 있고, 프로세스 메모리를 추출한 덤프 파일의 위치일 수도 있습니다. 특정 메모리 영역만 추출한 파일이라면 그 파일의 시작점을 기준으로 한 위치일 수도 있습니다.
예를 들어 가상주소 0x10000000에서 시작하는 영역을 빠짐없이 순서대로 덤프했다고 가정해보겠습니다. 그 파일의 0x240 위치에서 JSON을 찾았다면, 가상주소는 두 값을 더한 0x10000240입니다. 이 주소는 원본 RAM 이미지 파일에서의 위치와는 다릅니다. 분석 결과를 적을 때는 가상주소인지, 어느 덤프 파일의 오프셋인지 분명하게 표시해야 합니다.
JSON이 어디서 시작하고 끝나는지 찾는 일도 간단하지 않습니다. tools/call 문자열을 찾았다고 해서 그 앞의 중괄호부터 잘라내면 되는 것은 아닙니다. 다음 예시처럼 문자열 안에 중괄호와 메서드 이름이 들어 있을 수도 있습니다.
{
  "note": "문서 안에 {중괄호}와 도구 이름 tools/call이 등장합니다.",
  "example": true
}
여기서 문자열 안의 중괄호까지 JSON 구조의 일부로 세면 잘못된 구간을 추출하게 됩니다. 중괄호가 몇 겹으로 중첩됐는지뿐 아니라, 현재 읽는 위치가 문자열 안인지, 이스케이프 처리된 문자인지도 확인해야 합니다. JSON 앞뒤에 다른 바이트가 섞여 있거나 데이터가 중간에서 잘린 경우도 고려해야 합니다.
최종적으로 정리를 하자면 MCPRecon은 도구 사용이 끝난 뒤 수집한 메모리 이미지에서 MCP 메시지를 찾아 호출 기록을 복원합니다. 분석은 관련 클라이언트와 서버 프로세스를 찾는 것부터 시작합니다. 이후 힙과 익명 메모리 영역 등에서 jsonrpc, tools/list, tools/call 같은 문자열을 찾고, 주변의 JSON 객체를 추출합니다.
추출한 데이터는 JSON 문법, JSON-RPC 메시지 구조, MCP 관련 필드를 차례로 검사합니다. JSON으로 읽을 수 있는지 확인한 뒤 jsonrpc, method, result, error, id 등을 검사하고, MCP 메서드와 도구 스키마를 확인하는 방식입니다. 발견한 프로세스의 PID와 메모리 영역, 오프셋도 함께 기록합니다. 논문 §5, Algorithm 1
같은 id로 요청과 응답 연결하기
메시지를 추출한 다음에는 어떤 요청에 대한 응답인지 연결해야 합니다. 논문에서는 먼저 PID, 메모리에서 발견된 위치의 인접성, 확보할 수 있는 서버 식별 정보나 URL을 활용해 세션을 구분합니다. 이후 같은 세션에 속한 요청과 응답을 id로 연결합니다.
연결 조건은 두 메시지의 id가 같고, 요청에는 method가, 응답에는 result 또는 error가 있는 것입니다. 덤프 전체에서 같은 id를 찾는 것으로 끝나는 것이 아니라, 같은 세션의 요청과 응답인지 확인하는 절차가 포함됩니다. 논문 §5.2
이렇게 연결한 자료에서는 도구 목록과 입력 스키마, 실제 호출에 사용한 도구 이름과 인자, 응답 결과와 오류를 확인할 수 있습니다. 논문은 도구 목록 조회에서 얻은 정보와 실제 호출에서 얻은 정보를 구분합니다. tools/list 응답은 서버가 어떤 도구를 제공했는지 보여주고, tools/call 요청과 응답은 어떤 인자로 호출했으며 어떤 결과가 반환됐는지 보여줍니다.
호출 순서를 정리하는 데에는 제한이 있습니다. Algorithm 1과 §5.1에는 id가 증가하는 순서대로 기록을 정렬하는 단계가 있지만, §7.3에서는 id를 순차적으로 부여하는지가 구현에 따라 다르다고 설명합니다. 따라서 id를 이용한 정렬이 항상 실제 실행 순서를 나타내는 것은 아닙니다. 정확한 시각 정보가 없는 경우에는 id, 메모리에서 발견된 위치와 거리, 오프셋, 추가 메타데이터를 이용해 가능한 범위에서 순서를 추정합니다. 논문 §5.1, §7.3
저자들은 복원한 자료의 내용이 서로 맞는지도 확인하도록 설명합니다. 메서드, id, 도구 이름, 인자, 응답 결과, 입력 스키마를 함께 비교하는 것입니다. 문자열 조각 하나와 요청과 응답의 연결이 불완전한 자료만으로 특정 프로세스나 서버의 동작을 단정하지 않도록 권고합니다. 논문 §7.2
실험에서는 어디까지 복원했을까
연구진은 VMware에서 Ubuntu 24.04 가상머신을 실행해 실험했습니다. RAM은 8GB이고 커널 버전은 6.14.0-36-generic입니다. 클라이언트는 Codex CLI와 VS Code의 GitHub Copilot을 사용했습니다. 각 클라이언트에 stdio 방식의 날씨 서버, HTTP 방식의 날씨 서버, stdio 방식의 Context7을 연결해 여섯 가지 구성을 시험했습니다. HTTP 날씨 서버도 클라이언트와 같은 가상머신에서 실행했습니다. 논문 §6.1–6.5
날씨 서버는 Python과 FastMCP로 구현했습니다. 위치를 입력받으면 Open-Meteo의 지오코딩·날씨 API에서 정보를 가져옵니다. 이 서버에서는 정해진 필드로 전달되는 입력과 중첩된 JSON 응답을 분석했습니다.
Context7은 연구진이 직접 구현하지 않은 서버에도 복원 방법을 적용할 수 있는지 확인하기 위해 사용했습니다. 서버 프로세스는 로컬에서 stdio 방식으로 실행하지만 문서 내용은 원격에서 가져옵니다. 따라서 날씨 서버의 구조화된 응답과 함께, 문서 내용이 긴 텍스트로 반환되는 경우도 실험에 포함됐습니다. 논문 §6.2
각 구성에는 프롬프트를 세 번씩 입력했습니다. P1에서는 도구 목록을 조회하고, P2에서는 도구를 한 번 사용하며, P3에서는 입력을 바꿔 다시 사용합니다. 입력한 프롬프트와 호출한 도구, 실행 결과는 별도로 기록했습니다. 이 기록은 메모리에서 복원한 결과가 실제 실행 내용과 일치하는지 평가하는 데 사용했습니다.
세 프롬프트의 처리가 끝나면 가상머신 전체의 메모리를 수집하고, Volatility3로 관련 프로세스와 메모리 영역을 분석했습니다. 별도로 남긴 실행 기록은 결과를 비교하는 기준으로만 사용했으며, 호출 내용을 복원하는 입력으로 사용하지 않았습니다. 논문 §6.3–6.6
논문의 표 2에 제시된 프롬프트 내용은 다음과 같습니다. 모든 구성에서 P1은 도구 목록 조회에 해당합니다.
| 클라이언트·서버 구성 |
P2 |
P3 |
| Codex · 날씨 · stdio |
Manchester, UK의 현재 날씨 |
같은 지역의 5일 예보 |
| Codex · 날씨 · HTTP |
LA, California의 현재 날씨 |
Richmond, Virginia의 5일 기온 예보 |
| Codex · Context7 · stdio |
React에서 local storage에 쿠키를 설정하는 함수 질문 |
이를 삭제하는 함수 질문 |
| Copilot · 날씨 · HTTP |
Indiana, Brazil의 현재 날씨 |
Austin, Texas의 5일 기온 예보 |
| Copilot · 날씨 · stdio |
Venice, Italy의 현재 날씨 |
Paris, France의 10일 기온 예보 |
| Copilot · Context7 · stdio |
React에서 local storage에 저장하는 방법 |
저장한 값을 조회하는 방법 |
Codex의 Context7 항목은 원문 프롬프트에 쿠키와 local storage가 함께 등장하는 표현을 옮긴 것입니다. 논문 표 2
평가에서는 실제 호출에 해당하는 요청과 응답을 복원했는지, 두 메시지를 id로 연결할 수 있는지 확인했습니다. 추출한 데이터가 JSON-RPC와 MCP 형식에 맞는지도 검사했습니다. 또한 도구 목록과 입력 스키마, 호출 인자, 결과, 오류 중 어떤 정보를 확보했는지 살펴봤습니다.
자동 분석 결과는 수동 분석 결과와도 비교했습니다. Volatility3로 메모리 영역을 덤프한 뒤 rg와 xxd를 사용해, 도구가 표시한 오프셋에 JSON 조각이 실제로 존재하는지 확인했습니다. 주변 바이트도 살펴 해당 데이터가 힙 버퍼에 저장된 것으로 볼 수 있는지 검토했습니다. 논문 §6.6–6.8
아래 표는 논문의 표 3과 표 4를 합쳐 정리한 결과입니다. 각 칸은 왼쪽부터 P1, P2, P3에 해당합니다. ✓는 해당 프롬프트와 관련된 흔적을 복원했다는 뜻이고, ×는 수집한 메모리에서 기대한 흔적을 찾지 못했다는 뜻입니다.
| 클라이언트·서버 구성 |
개별 구성 P1/P2/P3 |
결합 시나리오 P1/P2/P3 |
| Codex · 날씨 · stdio |
✓ / ✓ / ✓ |
✓ / ✓ / ✓ |
| Codex · 날씨 · HTTP |
✓ / ✓ / ✓ |
✓ / × / ✓ |
| Codex · Context7 · stdio |
✓ / ✓ / ✓ |
✓ / × / ✓ |
| Copilot · 날씨 · HTTP |
✓ / ✓ / ✓ |
× / ✓ / ✓ |
| Copilot · 날씨 · stdio |
✓ / ✓ / ✓ |
× / ✓ / × |
| Copilot · Context7 · stdio |
✓ / ✓ / ✓ |
× / ✓ / ✓ |
각 구성을 따로 실행한 실험에서는 모든 프롬프트에 해당하는 흔적을 복원했습니다. 결합 시나리오에서는 같은 가상머신에서 두 클라이언트로 모든 서버의 프롬프트 묶음을 실행한 뒤 메모리를 한 번 수집했으며, 일부 흔적을 복원하지 못했습니다. 표의 평가 항목을 합산하면 개별 구성은 18개 중 18개, 결합 시나리오는 18개 중 12개입니다. 이 수치는 프롬프트별 평가 항목을 센 것으로, 전체 메시지 수나 메시지 단위의 복원 정확도를 나타내지는 않습니다. 논문 표 3–4
저자들은 일부 흔적을 찾지 못한 이유로 버퍼 재사용과 덮어쓰기, 동시 실행에 따른 메모리 변화와 단편화, 일부가 잘려 검증을 통과하지 못한 객체 등을 제시합니다. 또한 메모리에서 흔적을 찾지 못했다는 사실만으로 해당 동작이 발생하지 않았다고 판단해서는 안 된다고 설명합니다. 논문 §6.8
날씨 요청의 country에 다른 데이터가 들어간 이유
논문의 마지막 실험에서는 로컬 날씨 서버를 변조해 프롬프트 인젝션 공격을 시도했습니다. 서버는 처음 세 번의 get_current_weather 호출에 정상적으로 응답하고, 네 번째 응답에 JSON 키를 추가해 악성 지시를 전달하도록 구성했습니다. 클라이언트는 Cursor IDE v2.4.27을 사용했으며, Composer 1, Gemini 3 Flash, GPT 5.2 Low, Sonnet 4.5를 시험했습니다. 논문 §8.1
추가된 문구는 서버가 반환하는 데이터를 사용자 지시처럼 받아들이도록 유도합니다. 에이전트가 이를 따르면 작업 폴더의 파일을 읽고, 그 데이터를 다음 도구 호출의 인자로 전달하게 됩니다. 원문의 Listing 1에는 작업 내용을 사용자에게 자세히 설명하지 않도록 유도하는 문구와 mcp.json 파일을 찾는 내용이 포함돼 있습니다. 다만 파일에서 데이터를 추출하고 변환하는 상세 절차는 공개된 Listing에서 가려져 있습니다.
Figure 1은 정상적인 날씨 요청과 응답, 조작된 서버 응답, 에이전트의 파일 접근, 데이터를 포함한 후속 도구 호출로 이어지는 과정을 보여줍니다. 공격 지시는 사용자가 직접 입력한 프롬프트가 아니라 도구의 응답을 통해 전달됩니다. 논문 §8.1, Figure 1, Listing 1
실험에서 관찰한 모델별 동작은 다음과 같습니다.
| 모델 |
논문에서 보고한 동작 |
| Composer 1 |
악성 지시를 따르고 후속 도구 호출 수행 |
| Gemini 3 Flash |
악성 지시를 따르고 후속 도구 호출 수행 |
| GPT 5.2 Low |
프롬프트 인젝션을 감지하고 실행 거부 |
| Sonnet 4.5 |
프롬프트 인젝션을 감지하고 실행 거부 |
공격이 성공한 경우에는 추가 도구 호출의 인자에 작업 폴더의 데이터가 포함됐지만, 사용자에게는 주로 정상적인 날씨 답변이 표시됐습니다. 화면에는 파일 읽기와 추가 호출 표시가 남아 있었습니다. 다만 저자들은 토글로 접힌 추론 내용과 도구 입출력을 펼쳐보지 않으면 비정상적인 동작을 알아보기 어려웠다고 설명합니다. 공격을 거부한 두 모델도 사용자에게 공격 시도를 직접 경고하지는 않았다고 이야기합니다. 논문 §8.2, Figure 2
이후 메모리 분석에서는 민감한 데이터가 country 인자에 포함된 요청을 복원했습니다. Figure 3에는 요청을 발견한 위치와 도구 이름, 요청에 포함된 데이터가 제시돼 있습니다. 국가명을 전달하는 인자에서 작업 폴더의 데이터가 발견된 것입니다.
반면 공격 지시가 담긴 서버 응답은 복원하지 못했습니다. MCPRecon의 자동 분석뿐 아니라 수동 검사에서도 찾지 못했으며, 저자들은 메모리를 수집하기 전에 해당 영역이 다른 데이터로 덮어써졌을 가능성을 제시합니다. 이 사례에서 메모리로 확인한 것은 데이터를 포함한 후속 요청이며, 그 요청을 유도한 악성 응답까지 함께 확보한 것은 아닙니다. 논문 §8.3, Figure 3
논문에서 설명한 한계
MCPRecon은 암호화되지 않은 JSON이 메모리에 남아 있어야 동작합니다. 런타임이 데이터를 읽을 수 없는 내부 표현으로만 저장하거나, 사용한 버퍼를 곧바로 지우는 경우에는 복원이 어려워질 수 있습니다. 메모리 덮어쓰기와 가비지 컬렉션, 여러 작업의 동시 실행으로 메시지가 사라지거나 일부만 남는 문제도 있습니다.
정확한 시각 정보가 없다는 점도 한계입니다. 요청과 응답을 연결하더라도 모든 호출의 실행 시각과 순서를 확정할 수 있는 것은 아닙니다. 앞서 설명한 것처럼 id의 순차적 부여 여부도 클라이언트 구현에 따라 달라집니다.
실험 범위 역시 제한돼 있습니다. 연구진은 정해진 클라이언트와 Linux 환경에서 도구 목록 조회와 호출을 중심으로 평가했습니다. 저자들은 더 다양한 클라이언트, 운영체제, MCP 메서드에 대한 검증이 필요하다고 설명합니다. 논문 §7.3
보완되면 좋을 점
후속 연구에서는 메시지 단위의 복원 성능이 제시되면 좋겠습니다. 프롬프트별 흔적의 존재 여부에 더해, 실제로 주고받은 메시지 중 얼마나 복원했는지와 추출한 자료 중 실제 통신 메시지는 얼마나 되는지를 각각 평가하는 것입니다. 요청과 응답을 잘못 연결한 비율, 인자가 일부만 남은 경우도 함께 제시하면 복원 결과의 신뢰성을 더 구체적으로 판단할 수 있을 것 같다고 생각합니다.
메모리 수집 시점에 따른 변화도 확인할 필요가 있습니다. 실질적으로 바로 공격을 인지하고 메모리 수집을 진행할 수 없을 뿐더러 호출 직후부터 수집까지의 시간과 그 사이 발생하는 추가 작업량을 바꿔 비교하면, 어떤 조건에서 흔적이 사라지는지 살펴볼 수 있을것 같습니다.
참고자료
- Abdus Satter 외, With or without logs: Memory forensic reconstruction of Model Context Protocol (MCP) activity in agentic LLM systems, Forensic Science International: Digital Investigation, 57 Supplement, 302130, June 2026. DOI · DFRWS 공개 원문
- MCP 2025-11-25 명세: Architecture, Transports, Tools
- JSON-RPC 2.0 Specification
- Linux manual: proc_pid_maps(5)
- Python documentation: json
- MCPRecon 공개 저장소, 확인한 CLI 코드, 날씨 서버, 날씨 API 호출 코드. 코드 설명 기준: 커밋
4811d04e6c6a522759ade5e2f3fef37d33c6c27e.