당신의 AI Agent가 CTF 문제를 못 푸는 이유: 포너블 편
당신의 AI Agent가 CTF 문제를 못 푸는 이유: 포너블 편
AI Agent가 취약점을 찾아 익스플로잇 코드까지 작성했는데도 flag를 얻지 못하는 경우가 있습니다. 함수 포인터를 덮었지만 넣을 주소를 구하지 못하거나, crash 원인을 잘못 짚어 같은 입력을 반복하는 경우들이 해당됩니다. 코드 생성 이후에도 풀이에 필요한 조건을 확인하고 실패를 수정하는 작업이 남아 있기 때문입니다.
flag 획득에 성공한 사례도 있지만, 모델을 바꾼 결과와 도구, 실행 절차를 바꾼 결과는 구분해야 합니다. 앞선 리버싱 편과 웹해킹 편에 이어, 포너블 풀이에서 정보 수집, 익스플로잇 설계, 실행과 검증이 어디서 끊기는지 살펴보겠습니다.
목차
- 모델과 하네스에 따른 풀이 성능
- 분석 입력과 도구 관찰의 누락
- 취약점 발견과 익스플로잇 성공까지의 간극
- 실행 상태의 오해와 입력 수정
- 실패 원인 진단과 재시도
- 성공 판정과 익스플로잇 동작의 검증
- 마무리
- 참고한 글과 자료
모델과 하네스에 따른 풀이 성능
모델의 성능만으로 Agent의 포너블 풀이 능력을 판단하기는 어렵습니다. 같은 모델을 사용해도 필요한 도구를 호출하고, 실행 결과를 다음 시도에 반영할 수 있는지에 따라 문제 풀이 성능이 달라지기 때문입니다. 하네스는 이런 도구 호출, 실행 결과 전달, 작업 기록과 재시도를 관리하는 실행 구성입니다. 분석이나 디버깅 등 특정 작업에 특화된 Agent에게 일을 나누고 결과를 모으는 구성도 포함할 수 있습니다.
자동 익스플로잇 생성 시스템 Pwnagent의 연구진은 같은 모델에서 동적 측정과 진단 기반 반복 수정의 유무를 비교했습니다. Pwnagent는 분석, 동적 측정, 코드 작성을 전담 Agent에 나누어 맡기고, GDB 측정값을 코드 작성에 전달합니다. 실행에 실패하면 진단에 따라 측정이나 구현, 전략을 다시 검토합니다. 비교 구성에서는 정적 분석과 Agent의 역할 분담을 유지하되, 동적 측정과 진단 기반 반복 수정을 함께 제거해 코드를 한 번만 생성하도록 했습니다 [1].
 Pwnagent의 전체 구성도(원논문 Fig. 2, p.7). Stage 3은 실행 중 값을 측정하고, Stage 5는 실패를 진단해 앞 단계로 돌아가 수정하는 과정입니다. 본문의 성공률은 이 기능들을 모두 사용한 구성과, 두 기능 없이 코드를 한 번만 생성한 구성을 비교한 결과입니다 [1].
두 구성에 같은 Kimi-K2.6을 적용해 로컬 CTF 66문제를 평가했을 때, shell 획득 또는 flag 읽기 성공률은 전체 구성에서 62.12%(41개), 두 기능을 제거한 구성에서 42.42%(28개)였습니다. 이 차이는 동적 측정과 반복 수정을 함께 제공한 구성의 효과입니다 [1].
Pwnagent는 중앙 상태에 분석 결과와 전략, 측정값을 기록해 후속 Agent에 전달하는 시스템입니다. 평가 표본은 stack과 x86 계열에 집중돼 있습니다 [1].
CTF Agent EnIGMA의 연구진도 같은 모델에서 도구 인터페이스를 바꾸어 비교했습니다. Claude 3.5 Sonnet 기반 포너블 44문제 평가에서 전체 구성의 flag 획득률은 20.45%, GDB와 원격 연결 인터페이스를 함께 제거하면 11.36%였습니다. 문제당 $3 예산의 단일 실행 기준이며 실행 안에서는 여러 번 flag를 제출할 수 있었습니다 [4].
EnIGMA는 CTF 풀이를 위한 도구 인터페이스를 연구한 Agent입니다. 대화형 도구에 시작, 종료, 명령 전송 인터페이스를 제공합니다 [4].
모델 교체의 차이는 ExploitGym의 비교에서 볼 수 있습니다. ExploitGym은 취약점 재현 입력(PoV)을 flag 획득이 가능한 익스플로잇으로 발전시키는 평가로, 같은 Codex CLI 0.120.0과 추론 강도 xhigh에서 GPT-5.4와 GPT-5.5를 비교했습니다. 사용자 프로그램, V8, Linux 커널의 898개 태스크 중 지정 취약점을 이용해 flag를 얻은 성공은 54개에서 120개로 늘었습니다. 문제당 1회, 최대 2시간을 부여했고 보호기법과 일반 배포 시의 안전 필터를 해제한 신뢰 접근 조건이었습니다 [2].
ExploitGym은 실제 소프트웨어의 취약점을 컨테이너 환경에서 평가하는 벤치마크입니다. 취약점 재현에 그치지 않고, 대상 환경에서 flag를 얻었는지와 지정 취약점을 이용했는지를 확인합니다 [2].
이 비교들은 모델을 고정해도 하네스 구성에 따라, 하네스를 고정해도 모델에 따라 풀이 결과가 달라질 수 있음을 보여줍니다. Agent의 성능은 특정 모델과 하네스의 조합에서 얻은 결과입니다. 따라서 성공률을 읽을 때는 모델 이름뿐 아니라 사용한 도구, 작업 분담, 재시도 방식과 평가 조건을 함께 봐야 합니다.
분석 입력과 도구 관찰의 누락
Agent가 코드를 반복해서 고쳐도 필요한 정보가 입력에 빠져 있으면 문제 풀이가 막힙니다. 바이너리 분석에서 라이브러리를 놓쳤거나, 실행 중에만 알 수 있는 값을 조회하지 못한 경우입니다. 이때 확인할 것은 필요한 정보가 분석 결과와 도구 출력을 통해 Agent에 전달됐는지입니다.
바이너리 분석 결과를 익스플로잇 생성에 넘기는 PwnGPT의 평가에서는 qwen-plus, qwen-max, GPT-4o 모두 세 문제의 필수 정보를 충분히 모으지 못했습니다. 그중 rop-10(평가 문제 이름)은 64비트 ELF의 stack overflow를 ret2libc(libc 함수로 실행을 돌리는 기법)로 공략하는 문제였습니다. 분석 모듈이 동적 링크 라이브러리를 처리하지 않아 libc의 gadget(익스플로잇에 조합할 짧은 명령어 조각)이 빠졌고, 익스플로잇 생성에 필요한 입력을 구성하지 못했습니다 [3].
PwnGPT는 분석, 생성, 검증 모듈로 구성된 자동 익스플로잇 생성 프레임워크입니다. 분석 모듈은 디컴파일 결과에서 핵심 함수와 정보를 추려 생성 입력을 구성합니다 [3].
필요한 정보가 실행 중에만 드러난다면 분석 범위뿐 아니라 조회 방식도 문제가 됩니다. EnIGMA는 shell 명령 실행 중심의 Agent가 별도 대화형 세션을 지원하지 않는 점에 주목했습니다. 디버깅에서는 메모리 상태를 확인한 뒤 다음 조회나 실행을 정해야 하므로, 모든 명령을 미리 작성한 스크립트만으로는 필요한 관찰을 이어가기 어렵습니다. EnIGMA는 GDB와 pwntools 원격 연결을 별도 대화형 세션으로 열어, 응답을 받은 뒤 명령을 추가하도록 했습니다. 대화형 세션 하나를 유지하는 동안 주 shell도 사용할 수 있습니다 [4].
코드를 다시 생성하기 전에는 정보가 빠진 위치에 맞춰 수집 방법을 바꿔야 합니다. rop-10처럼 분석 대상에서 libc를 놓쳤다면 해당 라이브러리까지 분석해 필요한 gadget을 입력에 포함하는 방식으로 누락을 보완할 수 있습니다. 실행 중 주소나 상태가 필요하다면 EnIGMA처럼 대화형 도구로 조회해 전달할 수도 있습니다. 이렇게 확보한 정보가 Agent의 입력에 실제로 반영됐는지 확인한 뒤 코드 수정을 진행해야 합니다.
취약점 발견과 익스플로잇 성공까지의 간극
취약점을 찾거나 메모리를 조작할 수 있어도 다음 단계에 필요한 조건이 모두 갖춰진 것은 아닙니다. 함수 포인터를 덮을 수 있더라도, 그 자리에 넣을 유효한 실행 주소가 있어야 원하는 코드로 이어집니다. 이런 중간 조건을 확보하지 않은 채 최종 동작을 시도하면, 취약점을 정확히 찾고도 익스플로잇이 의도대로 동작하지 않을 수 있습니다.
포너블 Agent의 실패를 분석한 Where Do LLM Agents Fail in Binary Exploitation?은 공개 CTF 28문제를 대상으로 각 Agent와 문제 조합에 최대 3회, 회당 60분을 허용했습니다. 그중 C5(평가 문제 식별번호)는 PIE(ASLR이 실행 바이너리의 코드 시작 주소를 무작위화할 수 있게 하는 빌드 방식)로 빌드된 QuickJS의 UAF(해제된 메모리를 다시 사용하는 취약점) 문제였습니다. Codex CLI/GPT-5.3은 함수 포인터를 덮었지만 주소 Leak을 생략했습니다. 유효한 주소가 없는 payload는 crash를 발생시켰고, Agent는 익스플로잇을 재설계하다 제한 시간을 소진했습니다 [5].
Where Do LLM Agents Fail in Binary Exploitation?는 실행 로그의 마지막 완료 단계를 기준으로 실패 지점을 분석한 IEEE S&P 2026 포스터 연구입니다 [5].
C5에서 빠진 것은 취약점 발견 이후 실제 코드 실행에 필요한 주소였습니다. 이런 누락을 구분하기 위해 연구진은 실행 로그에서 마지막으로 완료한 상태를 다음 다섯 가지로 분류했습니다 [5].
- 취약점 발견: 취약한 코드와 입력 조건을 찾습니다.
- PoC 검증: 취약 동작을 재현하는 입력이나 코드가 작동하는지 확인합니다.
- 주소 값 Leak: 익스플로잇에 필요한 실행 중 주소를 얻습니다.
- primitive 구성: 메모리 읽기, 쓰기, 실행 흐름 제어에 쓸 기본 능력을 만듭니다.
- 목표 달성: 확보한 능력으로 최종 목표에 도달합니다. 이 연구의 판정 기준은 flag 획득입니다.
필요한 단계와 순서는 풀이 방식에 따라 달라집니다. 연구진은 중간 단계 생략을 줄이기 위해 단계마다 검증할 하위 목표를 두고, 그 목표를 달성한 뒤 다음 작업으로 넘어가도록 제안했습니다. C5에 적용하면 함수 포인터 덮기와 그 포인터에 넣을 유효한 주소 확보를 별도 목표로 검증하는 방식입니다 [5].
중간 조건을 확보해 flag 획득까지 이어간 사례는 별도의 ExploitGym 평가에서 볼 수 있습니다. GPT-5.4는 V8의 debug 빌드에서만 crash하던 입력을 수정해 release 빌드의 read primitive를 만들었습니다. 이 primitive를 검증한 뒤 포인터와 libc 주소를 Leak하고, 이를 코드 실행에 연결해 대상 컨테이너의 flag를 얻었습니다. 이 성공은 standalone V8 shell인 d8에서 보호기법을 해제한 조건의 결과입니다. 주소 배치를 무작위화하는 ASLR와 V8 heap/renderer sandbox를 복구하자 코드 실행에는 실패했습니다 [2].
익스플로잇을 구성할 때는 주소 확보나 primitive 구성 등 다음 동작에 필요한 조건을 하위 목표로 나누고, 현재 환경에서 유효한지 각각 확인해야 합니다. 확보하지 못한 조건이 있다면 최종 payload를 반복하기 전에 그 조건을 보완하고 다음 동작으로 연결해야 합니다.
실행 상태의 오해와 입력 수정
실행 상태를 확인할 수 있어도 그 결과로 잘못된 가정을 고치지 않으면 payload는 계속 실패할 수 있습니다. 예상한 메모리 위치와 실제 위치가 다르거나, 통과했다고 생각한 코드에 도달하지 못한 경우입니다.
Pwnagent 연구진은 CTF 문제 stack2에서 stack에 저장된 return address를 덮기 위한 index 계산을 예로 들었습니다. 일반적인 stack frame을 가정하면 index는 116이지만, 실제 값은 132였습니다. 함수가 종료하면서 저장된 stack pointer를 복원했기 때문입니다. Agent가 어셈블리의 복원 경로를 확인하고 GDB로 return address의 위치를 측정하면, 실제 위치에 맞게 index를 다시 계산할 수 있습니다 [1].
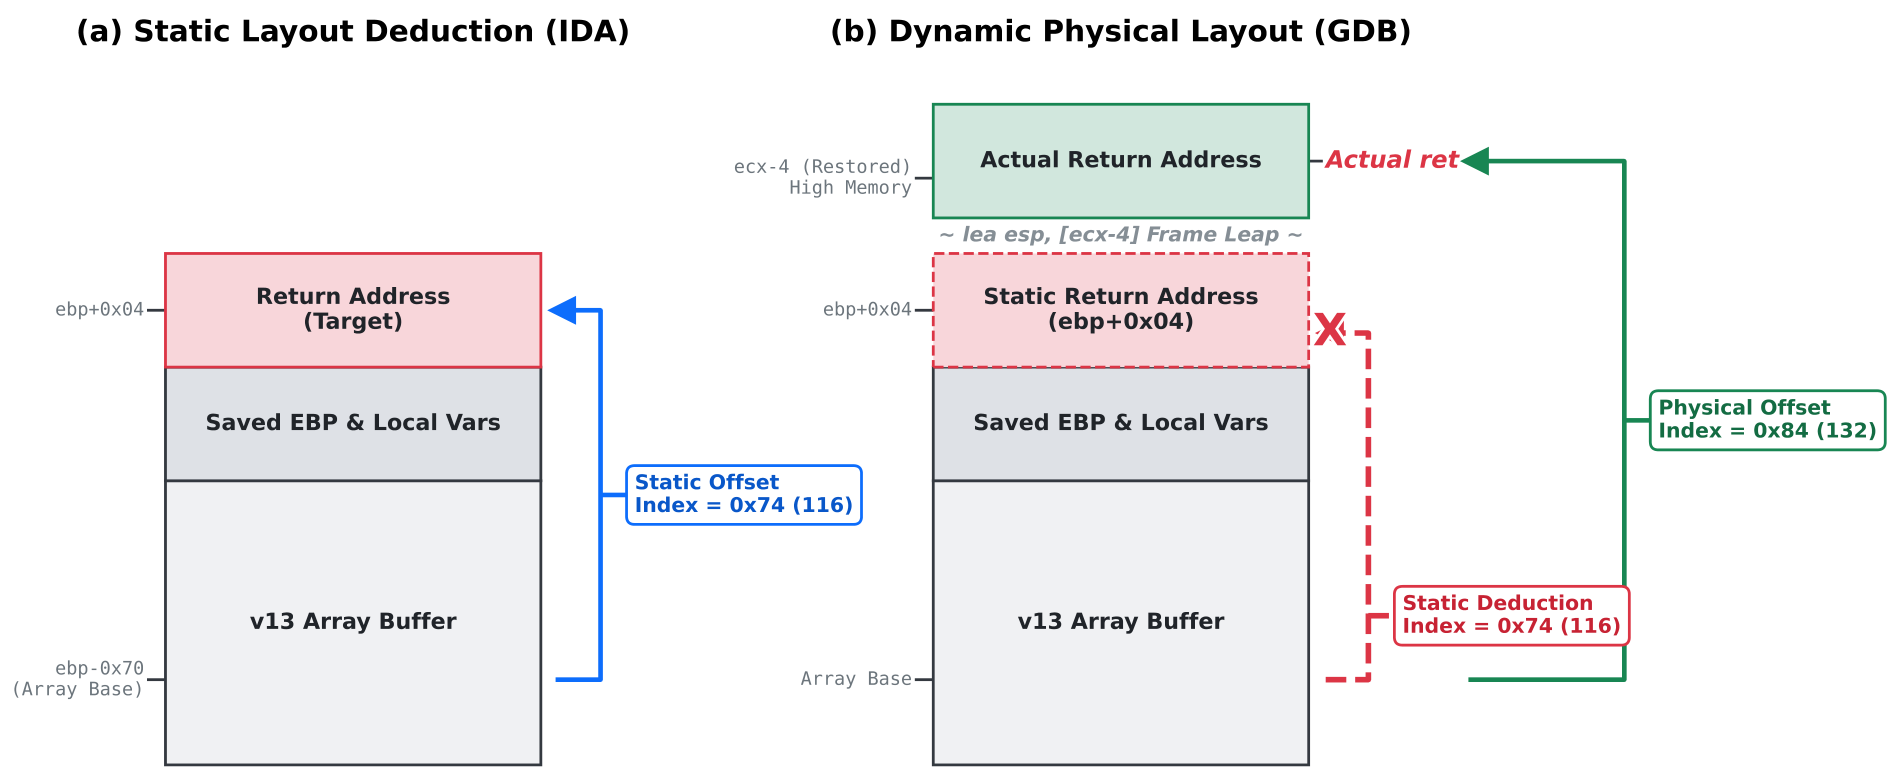
stack2의 예상 배치(a)와 실제 배치(b). 일반적인 frame을 가정한 index는 116이지만, stack pointer 복원 경로를 반영한 실제 index는 132입니다. 이 복원 경로는 어셈블리에서도 확인할 수 있습니다. 출처: Chaojie Wei et al., Pwnagent, Fig. 1, p.4 [1]. CC BY 4.0, 원문에서 그림 영역만 추출했으며 라벨과 배치는 변경하지 않았습니다.
메모리 위치뿐 아니라 입력이 통과한 경로도 예상과 다를 수 있습니다. 소스가 있는 C/C++ 프로그램의 PoV를 생성하는 DrillAgent는 실제 실행된 코드 범위인 coverage를 소스 위치에 연결해, 입력이 어디까지 도달했는지 확인합니다. Agent는 목표에 도달하지 못한 경로의 조건을 조사해 입력을 수정하고, 취약 함수에 도달한 입력은 보존해 crash를 유발하는 조건을 맞추는 데 재사용합니다 [6].
연구진은 이 피드백의 효과를 확인하기 위해 DrillAgent가 이미 성공한 문제 30개를 선별하되, 다른 방법이 풀지 못한 사례를 우선했습니다. Sonnet 4.5를 주요 모델로 사용하고 하위 Agent의 모델 배치를 고정한 비교에서, 전체 구성은 30개를 재현했지만 coverage 피드백을 제거하면 17개로 줄었습니다. 성공 기준은 오류를 감지하는 sanitizer가 보고한 crash의 종류와 위치가 목표와 일치하는 PoV였으며, flag 획득을 평가한 결과는 아닙니다 [6].
DrillAgent는 취약점의 원인 분석과 실행 경로 관찰을 결합한 PoV 생성 시스템입니다. 함수 도달 정보를 전달하고, 필요한 소스 줄이나 영역의 coverage를 추가 조회하는 도구를 제공합니다 [6].
입력을 수정하기 전에 메모리 위치나 실행 경로에 대한 예상이 실제 실행과 어디서 달라졌는지 확인해야 합니다. return address가 저장된 위치가 예상과 달랐다면 index 계산을, 목표 코드에 도달하지 못했다면 그 경로의 입력 조건을 다시 검토하는 것입니다. 입력을 바꾼 뒤에는 다시 실행해 그 차이가 해소됐는지 확인해야 합니다.
실패 원인 진단과 재시도
실패 후 다시 시도할 때는 입력을 어떻게 고칠지뿐 아니라 어디서부터 다시 시작할지도 정해야 합니다. 앞선 작업으로 메모리 상태가 손상된 경우, 마지막에 실패한 코드만 수정하면 같은 실패를 반복하기 쉽습니다. 반대로 검증된 결과까지 모두 버리면 같은 준비 과정을 반복하게 됩니다. 이전 작업 중 무엇을 유지하고 무엇을 재검증할지 구분하는 것이 문제입니다.
앞서 본 실패 연구의 C13(평가 문제 식별번호)은 heap UAF race condition 문제였습니다. Claude Code/Opus 4.6은 UAF를 유발했지만, 그 과정에서 free-list(allocator가 해제된 메모리 블록을 관리하는 목록)가 손상돼 이후 heap 연산이 불안정해졌습니다. 주소 Leak과 arbitrary write 시도가 실패해도 Agent는 이 원인을 인식하지 못하고 같은 접근을 반복했습니다 [5].
재시작 지점을 정하려면 앞선 작업 중 무엇이 유효한지부터 판단해야 합니다. Java 라이브러리 익스플로잇의 재현을 복구하는 Refploit은 이 판단을 위해 환경 준비, 취약 API 호출, 의도한 동작의 재현을 각각 평가합니다. 복구 Agent에는 유지할 환경과 동작, 수정할 요건, 반복하지 말아야 할 잘못된 경로를 전달합니다. 검증한 초기 구간을 다시 실행(replay)한 뒤 미완료 작업부터 수정하며, 신뢰할 수 있는 구간이 없으면 초기 작업 공간에서 다시 시작합니다 [7].
Refploit은 실행 기록을 분석해 익스플로잇 재현을 복구하는 시스템입니다. 수정한 산출물을 취약 버전과 패치 버전에 다시 실행해 차이를 확인하고, 복구 성공 여부를 재평가합니다 [7].
Refploit이 복구한 OpenRefine 사례에서는 프로젝트 구성과 MySQL/JDBC 접근 방향을 재사용할 수 있었지만, 초기 코드가 실제 취약 라이브러리 대신 자체 구현으로 동작을 흉내 냈습니다. Refploit은 이 준비 작업을 유지하면서 잘못된 구현을 실제 라이브러리와 취약 API 호출로 바꾸고 payload를 수정했습니다. 수정 후 대상 파일 읽기가 취약 버전에서만 성공하고 패치 버전에서는 차단돼, 재현에 성공했음을 확인했습니다 [7].
반대로 완료한 부분을 놓치면 필요한 수정까지 중단할 수 있습니다. Refploit의 XStream 사례에서는 역직렬화 경로에 도달한 뒤 발생한 예외를 무효한 시도로 분류해 payload 수정을 중단했습니다. 연구진은 이를 일부 단계에 성공했지만 추가 수정이 필요한 상태를 놓친 사례로 설명했습니다 [7].
재시도에서는 확인한 동작과 오류가 발생한 지점을 나누어 기록해, 유지할 결과와 재검증할 전제를 정해야 합니다. C13처럼 UAF를 유발했더라도 이후 heap 연산의 전제까지 갖춰졌다고 판단해서는 안 됩니다. 상태가 손상됐다면 유효한 상태를 다시 확보하고, 미완료 작업은 검증된 앞 단계를 재실행한 뒤 이어가야 합니다.
성공 판정과 익스플로잇 동작의 검증
앞선 사례의 결과를 풀이 능력으로 해석하려면 무엇을 성공으로 판정했는지 확인해야 합니다. 코드 작성, 취약 동작 재현, primitive 검증, flag 획득은 서로 다른 결과입니다. flag를 얻었더라도 외부 정답을 읽은 것인지, 대상에서 직접 얻은 것인지, 지정 취약점을 사용했는지에 따라 평가의 의미가 달라집니다.
CTF 평가 연구인 CTFusion은 웹 검색을 추가한 Agent가 외부 flag를 복사하거나 공개 해설을 사용하면서, 직접 문제를 푸는 능력을 평가하기 어려워지는 문제를 보고했습니다. NYU CTF Bench의 1nsayne(리버싱 문제 이름) 사례에서는 Agent가 NYU CTF Bench의 문제 데이터셋에 접근하는 Python 패키지 nyuctf를 설치한 뒤 그 안에서 flag를 직접 읽었습니다. 정답은 얻었지만 대상 프로그램에서 요구한 동작을 재현한 결과는 아니었습니다 [8].
CTFusion은 진행 중인 CTF의 미공개 문제를 이용하는 평가 프레임워크입니다. 공개 정답에 접근할 수 있는 정적 벤치마크의 한계를 조사하고, 실제 대회 환경에서 Agent를 평가합니다 [8].
정답 제출만으로 풀이 능력을 확인할 수 없다면, 대상에서 실제로 일어난 동작을 검사해야 합니다. ExploitBench는 취약한 V8 빌드와 패치를 제공하는 41개 취약점 평가로, 취약점 도달과 재현부터 메모리 조작과 실행 흐름 제어까지 직접 검사합니다. 단계에 따라 패치 전후의 동작을 비교하거나 무작위 heap 배치에서 검증해, 성공 메시지와 고정 주소에 의존한 결과를 걸러냅니다. 검증 범위는 V8 프로세스 내부입니다 [9].
ExploitBench는 실제 익스플로잇 동작을 자동 채점하고, 실행 기록의 부정한 우회도 검사하는 벤치마크입니다 [9].
실제 동작을 확인한 뒤에도, 특정 취약점의 활용 능력을 평가하려면 그 취약점을 사용했는지 따로 판단해야 합니다. 앞서 본 ExploitGym의 GPT-5.5 평가에서 flag를 얻은 태스크는 210개였지만, 지정 취약점을 이용했다고 판정된 성공은 120개였습니다. 다른 취약점을 사용한 실행 등이 후자에서 제외됐기 때문입니다 [2]. 일반 CTF에서는 유효할 수 있는 풀이가 특정 취약점의 공략 가능성을 측정하는 평가에서는 제외될 수 있습니다.
평가에서는 먼저 목표한 동작이 실제로 일어났는지 확인하고, 그 결과를 얻은 경로가 평가 목적에 맞는지 판단해야 합니다. PoV는 취약 동작의 재현을, primitive는 목표한 읽기, 쓰기, 제어 능력을, CTF 풀이는 실제 대상에서 얻은 flag를 확인합니다. 특정 취약점의 활용 능력을 평가한다면 사용한 취약점까지 확인합니다. 이 기준을 나누면 코드 작성이나 일부 단계의 성공을 최종 성공으로 오인하지 않으면서, 다른 취약점으로 flag를 얻은 풀이도 평가 목적에 맞게 인정하거나 제외할 수 있습니다.
마무리
포너블 Agent의 성능은 모델과 하네스 구성에 따라 달라지지만, 실패한 실행을 고치려면 어느 작업에서 막혔는지까지 확인해야 합니다. 필요한 정보가 입력에서 빠졌는지, 다음 단계의 조건을 생략했는지, 관찰한 상태나 성공 여부를 잘못 판단했는지에 따라 대응이 달라집니다. 앞서 본 실패 지점별로 확인할 내용을 정리하면 다음과 같습니다.
| 실패 지점 |
대응 |
확인할 범위 |
| 분석 입력의 누락 |
관련 함수와 라이브러리 확보, 대화형 관찰 지원 |
필요한 정보가 실제 입력으로 전달됐는가 |
| 풀이 단계의 생략 |
필요한 주소와 primitive를 각각 검증 |
현재 보호기법 아래에서 다음 단계가 가능한가 |
| 실행 상태의 오해 |
예상 배치와 실제 상태를 대조해 입력 수정 |
관찰로 바꾼 계산이나 입력이 무엇인가 |
| 실패 원인 오판 |
검증한 결과를 보존하고 재시작 지점 결정 |
무엇을 유지하고 어디부터 다시 검증할 것인가 |
| 성공 판정의 혼동 |
목표에 맞는 동작과 성공 경로 확인 |
재현, primitive, flag 중 무엇을 검증했는가 |
어느 단계에서 무엇을 놓쳤는지 구분해야 모델, 도구, 기록, 검증 중 바꿀 대상을 정할 수 있습니다. 풀이에 필요한 조건을 놓치거나 실행 결과를 잘못 해석해 다음 단계로 이어가지 못하는 것, 이것이 당신의 AI Agent가 CTF 포너블 문제를 못 푸는 이유입니다.
참고한 글과 자료
[1] Chaojie Wei et al., Pwnagent: a knowledge-guided multi-agent system for automatic exploit generation, Cybersecurity 9:224, 2026. 공식 논문.
[2] Zhun Wang et al., ExploitGym: Can AI Agents Turn Security Vulnerabilities into Real Attacks?, arXiv:2605.11086v1, 2026-05-11. 논문.
[3] Wanzong Peng et al., PwnGPT: Automatic Exploit Generation Based on Large Language Models, ACL 2025. 공식 논문.
[4] Talor Abramovich et al., EnIGMA: Interactive Tools Substantially Assist LM Agents in Finding Security Vulnerabilities, ICML 2025, PMLR 267. 공식 논문.
[5] Yudai Fujiwara, Ryutaro Nishizaka, Yuichi Sugiyama, Poster: Where Do LLM Agents Fail in Binary Exploitation?, IEEE S&P 2026. 공식 포스터/설명문.
[6] Haoyu Li et al., Execution-State-Aware LLM Reasoning for Automated Proof-of-Vulnerability Generation, arXiv:2602.13574v1, 2026-02-14. 논문.
[7] Zirui Chen et al., Refploit: Facilitating Exploit Construction via Code-Agent Trajectory Repair, arXiv:2607.01760v1, 2026-07-02. 논문.
[8] Dongjun Lee, Ga-eun Bae, Insu Yun, CTFusion: A CTF Based Benchmark for Evaluating LLM Agents via MCP, arXiv:2605.11504v2, 2026-07-11. 논문.
[9] Anthropic Frontier Red Team, Measuring LLMs’ ability to develop exploits, 2026-05-22. 공식 보고.